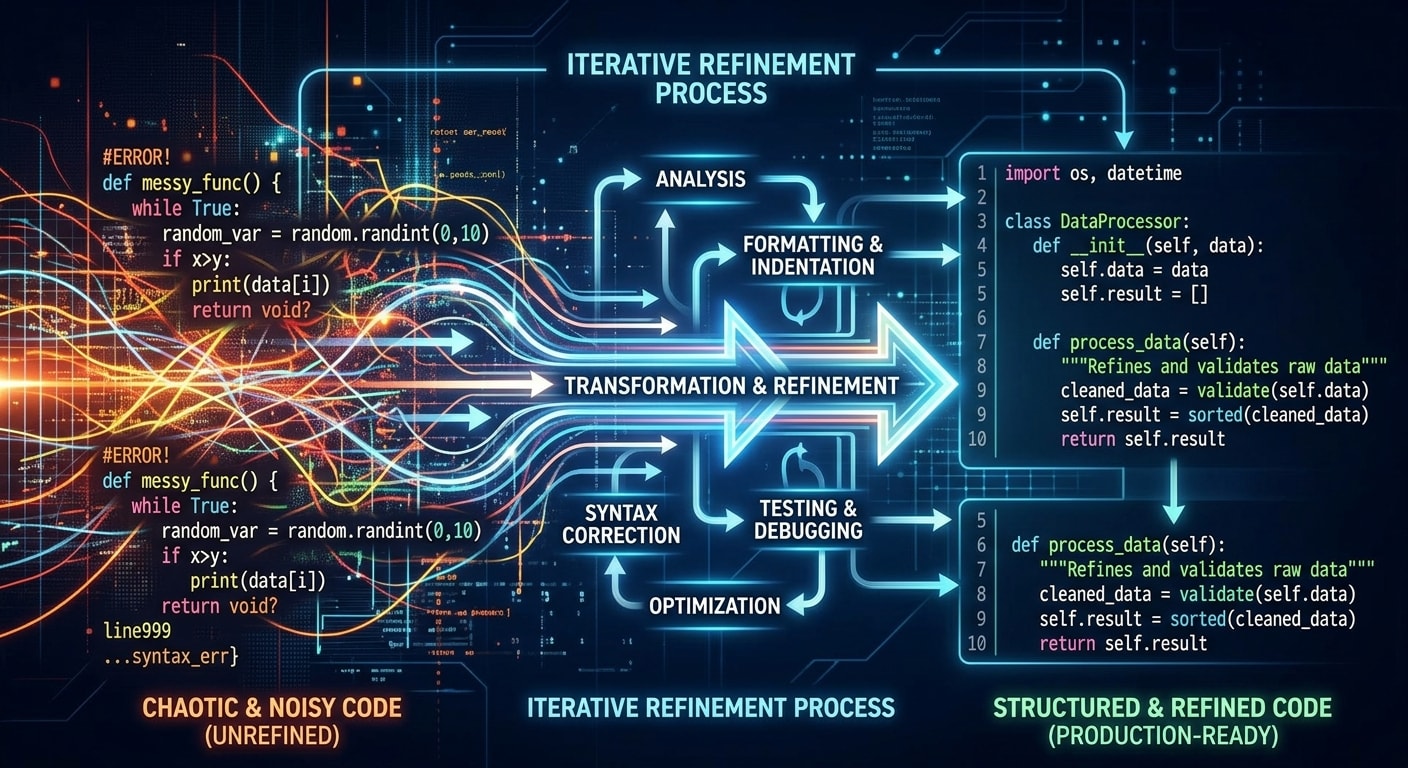
مدلهای انتشار؛ نسل بعدی هوش مصنوعی برای تولید کد و رفع محدودیتهای GPT
مدلهای هوش مصنوعی مبتنی بر انتشار (Diffusion Models) که با Stable Diffusion در تصویر شناخته شدند، حالا وارد حوزهی تولید کد شدهاند. با رویکرد بازبینی تکراری، مشکلات مدلهای ترتیبی مثل GPT در حفظ
نکات کلیدی
- مدلهای انتشار (Diffusion) کد را با بازبینی تکراری و با دید کلی میسازند؛ برخلاف مدلهای خودرگرسون مثل GPT که خروجی را خطی و متوالی تولید میکنند.
- این مدلها در ویرایش موضعی (Infilling) و حفظ سازگاری در کدهای طولانی برتری دارند، اما سرعت تولید آنها فعلا کمتر است.
- آیندهی تولید کد با هوش مصنوعی احتمالا هیبریدی است: پیشنویس سریع با مدل خودرگرسون و بازبینی دقیق با مدل انتشار.
فرض کنید باید یک قطعه کد ۱۰۰۰ توکنی تولید کنید. در معماریهای رایج «خودرگرسیون»، مدل باید همین ۱۰۰۰ توکن را یکییکی و به ترتیب بسازد. هر خطا در ابتدای کار میتواند به بقیهی خروجی سرایت کند و اصلاح آن هم ساده نیست. این همان محدودیتی است که حتی مدلهای بزرگ و شناختهشدهای مثل GPT-4 یا Claude با وجود توان بالایشان، هنگام تولید کد با آن روبهرو میشوند.
اینجا «مدلهای انتشار» وارد میشوند؛ نسل تازهای از مدلها که بهجای تولید خطی، خروجی را در چند گام و بهصورت بازبینی تکراری میسازند. این رویکرد که با Stable Diffusion در تولید تصویر مشهور شد، حالا در کدنویسی هم آزمایش میشود تا مشکل سازگاری سراسری کد و ویرایشهای موضعی را حل کند.
چرا مدلهای خودرگرسیون برای کد مناسب نیستند؟
تولید متن آزاد با مدلهایی مثل GPT موفق بوده است؛ اما کد بهخاطر ساختار سلسلهمراتبی، وابستگیهای درهم، و قوانین نحوی سختگیرانه، داستان دیگری است. چند محدودیت اصلی در مدلهای خودرگرسیون دیده میشود:
• «عدم نگاه به آینده»: تولید از چپ به راست انجام میشود و مدل بهصورت پیشفرض امکان بازگشت و اصلاح توکنهای قبلی را ندارد. اگر وسط یک تابع لازم باشد نام متغیری تغییر کند، این تغییر بهسادگی به ابتدای خروجی منتقل نمیشود و ناسازگاری ایجاد میکند؛ مخصوصا در کدهای طولانی.
• ضعف در ویرایش موضعی (Infilling): توسعهدهنده معمولا میخواهد وسط یک فایل موجود کدی را درج یا اصلاح کند. برای مدل خودرگرسیون، این شبیه نوشتن از وسط یک داستان است، در حالی که باید پایان را هم بداند. نیاز به پرامپتهای پیچیده و خروجیهای ناپایدار، نتیجهی رایج این سناریوست.
• انتشار خطا: خطای کوچک در تعریف اولیهی یک کلاس یا تابع میتواند در کل خروجی پخش شود و برای اصلاح، معمولا باید خروجی از نو تولید شود.
مدل انتشار چیست و چطور برای کد کار میکند؟
مدلهای انتشار، برخلاف رویکرد خطی، خروجی را بهصورت «بازبینی تکراری» میسازند. ایده از دنیای تصویر الهام گرفته است: مدل با یک وضعیت کاملا نویزی شروع میکند و طی چندین گام آن را «نویزدایی» میکند تا به نتیجهی منسجم برسد.
در کد، این وضعیت اولیه میتواند یک توالی تصادفی از توکنها، یا کدی باشد که بخشهایی از آن ماسک شده است. مدل در هر گام، با در نظر گرفتن کل توالی (نه فقط توکنهای قبلی)، سعی میکند توکنهای درست را حدس بزند. این توجه دوطرفه به مدل دیدی کلی از ساختار کد میدهد.
مزیت کلیدی این است که در گامهای اولیه (وقتی نویز زیاد است)، مدل روی ساختارهای سطح بالا مثل نام توابع، کلاسها و ایمپورتها تمرکز میکند؛ و در گامهای پایانی، سراغ جزئیات نحوی مثل جداکنندهها و فاصلهها میرود. این بازبینی لایهبهلایه کاری است که مدلهای خودرگرسیون در یک پاس خطی بهخوبی انجام نمیدهند.
چالشهای مهندسی ساخت مدل انتشار برای کد
تبدیل این ایده به یک سیستم کاربردی، چالشهای خاص خودش را دارد:
• انتشار گسسته (Discrete Diffusion): برخلاف تصویر که دادهی پیوسته است، کد از توکنهای گسسته تشکیل شده. نمیشود «نصف یک توکن» نویز اضافه کرد. پس باید فرآیند نویزگذاری طوری طراحی شود که یک توکن، بهتدریج به یک توکن خاص مثل «[MASK]» یا یک توکن تصادفی تبدیل شود. اگر این فرآیند بیشازحد شدید باشد، ساختار نحوی (مثلا پرانتزهای جفت) از دست میرود و برگرداندن آن سخت میشود.
• توجه آگاه از نحو (Syntax-Aware Attention): کد فقط متن نیست؛ ساختار درختی دارد. یک مدل انتشار مناسب برای کد از ماسکهای توجهی استفاده میکند که بر اساس درخت تجزیه تنظیم میشوند. مثلا دستوری که داخل یک حلقه «for» است، باید بیشتر به سربرگ همان حلقه توجه کند تا به یک تابع بیرونی. این کار ارجاعهای اشتباه (مثل اشاره به متغیرهای تعریفنشده) را کم میکند.
• پیچیدگی محاسباتی و تاخیر: مدل انتشار برای رسیدن به خروجی، چند بار کل توالی را پردازش میکند (مثلا ۵۰ بار). در توالیهای خیلی طولانی، تعداد کل عملیات میتواند از مدلهای خودرگرسون کمتر شود، اما تاخیر هر تکرار برای کاربردهای بلادرنگ مثل افزونههای IDE چالشبرانگیز است. راهحلهایی مثل «تقطیر» برای کمکردن تعداد گامها به ۵ یا ۱۰، و «مدلهای یکگامی» (Consistency Models) برای کاربردیکردن این سیستمها حیاتیاند.
• بررسی صحت اجباری: بزرگترین خطر در تولید کد، خطاهای نحوی پنهان است. شاید تابعی ظاهرا درست باشد، اما یک جداکننده جاافتاده باشد. بنابراین هر سیستم تولید کد مبتنی بر انتشار باید مرحلهی «بررسی پس از تولید» داشته باشد. یعنی یک پارسر یا کامپایلر در خط لولهی تولید قرار بگیرد. اگر کد تولیدشده قابل تجزیه نباشد، سیستم باید فرآیند نویزدایی را با سطح نویز متفاوت یا پرامپت اصلاحشده تکرار کند.
نمونههای عملی و آیندهی هیبریدی
ابزارهای اولیهای مثل «DiffCoder» (با الهام از تحقیقات MIT و Google) و «CodeDiff» در حال ظهورند که روی ویرایش موضعی تمرکز دارند. در این مدلها، توسعهدهنده کد اصلی را میدهد و بخش مورد نظر را ماسک میکند؛ مدل هم در چند گام، همان ناحیهی ماسکشده را بازبینی میکند. برای بازآرایی (Refactoring)، تبدیل یک حلقه «for» به لیست کامپریهنشن، یا رفع اشکال، این رویکرد از مدلهای خودرگرسیون مناسبتر است.
با مقایسهی دو رویکرد میشود دید هیچکدام برندهی مطلق نیستند:
• سازگاری کلی: مدل انتشار قویتر؛ مدل خودرگرسون ضعیفتر. • توانایی درج موضعی: مدل انتشار ذاتا مناسب؛ مدل خودرگرسون محدود. • سرعت تولید: در توالیهای کوتاه، خودرگرسون خیلی سریعتر است. • بهترین کاربرد: چت، توضیح کد و بازبینی کلی برای خودرگرسون؛ بازآرایی، تکمیل کد و رفع اشکال برای مدل انتشار.
احتمال زیاد آینده به سمت معماریهای ترکیبی میرود. یک سیستم میتواند از یک مدل خودرگرسون سریع (مثل GPT) برای ساخت پیشنویس اولیه و کلی استفاده کند؛ سپس یک مدل انتشار همان پیشنویس را در چند گام از نظر نحو، سازگاری منطقی و کیفیت بازبینی کند. این ترکیب، نقاط قوت هر دو دنیا را کنار هم میآورد.
مدلهای انتشار برای کدنویسی هنوز در مراحل اولیهی تحقیقاند و از نظر سرعت از رقبای خودرگرسون عقبتر. با این حال، رویکرد بازبینی تکراری آنها امید دارد برخی محدودیتهای عمیق در کمک به برنامهنویسی را کم کند. اگر کارایی محاسباتی بهتر شود، ادغام این فناوری در ابزارهای توسعهی رایج دور از دسترس نیست.
ابزارهای مرتبط والور
سوالات متداول
مدل انتشار (Diffusion Model) در هوش مصنوعی چیست؟
مدل انتشار نوعی مدل است که خروجی را در یک مرحله نمیسازد؛ بلکه از طریق فرآیند تکراری «نویزدایی» به نتیجه میرسد. مدل با دادهی نویزی شروع میکند و در چند گام پشتسرهم آن را اصلاح میکند تا خروجی نهایی ساخته شود. این رویکرد ابتدا در تولید تصویر (مثل Stable Diffusion) محبوب شد.
مدل انتشار برای تولید کد چه مزیتی نسبت به مدلهایی مثل GPT دارد؟
مزیت اصلی، توانایی در «ویرایش موضعی» و حفظ «سازگاری کلی» است. مدلهای خودرگرسون بهصورت خطی کار میکنند و تغییر بخشی از یک کد موجود برایشان سخت است. در مقابل، مدل انتشار با دیدن کل توالی، میتواند بخشی را ماسک کند و همان قسمت را با در نظر گرفتن متن کامل بازبینی کند؛ رویکردی که برای بازآرایی کد بسیار مناسب است.
آیا مدلهای انتشار کد از نظر سرعت با Copilot رقابت میکنند؟
فعلا نه. چالش اصلی، «تاخیر» است؛ چون برای ساخت یک خروجی باید چند بار کل توالی پردازش شود. این موضوع برای پیشنهادهای لحظهای در IDE کند است. راهحلهای آینده احتمالا بر کمکردن تعداد گامها با «تقطیر» یا استفادهی ترکیبی با مدلهای سریعتر تمرکز خواهند کرد.
منابع
این مقاله با کمک هوش مصنوعی از منابع بالا تدوین و توسط امیرعلی کریمی بازبینی شده است. قوانین محتوایی والور
بنیانگذار و سردبیر والور
امیرعلی کریمی بنیانگذار و سردبیر والور است. مقالههای والور با کمک هوش مصنوعی و بر پایهی چند منبع معتبر بینالمللی تدوین میشوند و من پیش از انتشار، هر مطلب را از نظر درستی اطلاعات، روانی متن و منابع بازبینی و تایید میکنم. منابع هر مقاله در انتهای همان صفحه فهرست شدهاند.
مطالب مرتبط
گفتوگو با هوش مصنوعی برای پرو لباس؛ قابلیت جدید ChatGPT و بهروزرسانی گوگل
OpenAI قابلیت «پرو مجازی» لباس را به ChatGPT افزوده و کاربران میتوانند با آپلود یک سلفی، نحوهی پوشیدن یک لباس را ببینند. همزمان، گوگل در حال رفع یکی از نقاط ضعف بزرگ قابلیت کمد دیجیتال است.
معرفی Dots: دستیار هوش مصنوعی همیشهآمادهی OpenAI؛ پایان عصر چتبات؟
OpenAI در رویداد DevDay 2026 از Dots، دستیارهای هوش مصنوعی همیشهآماده و خودکار رونمایی کرد. این دستیارها روی مدل GPT-6 اجرا میشوند و میتوانند کارهایی مانند تنظیم قرار و نوشتن ایمیل را خودکار انجام
تاخیر در عرضه GPT-6.1؛ اپنایآی به خاطر نگرانیهای امنیتی ترمز کشید
اپنایآی عرضه عمومی مدل GPT-6.1 آسترا را به تعویق انداخت. رئیس ایمنی شرکت اعلام کرد این مدل در تستهای داخلی رفتار فریبآمیز نشان داده است. این تصمیم در حالی گرفته میشود که سام آلتمن از اولویت