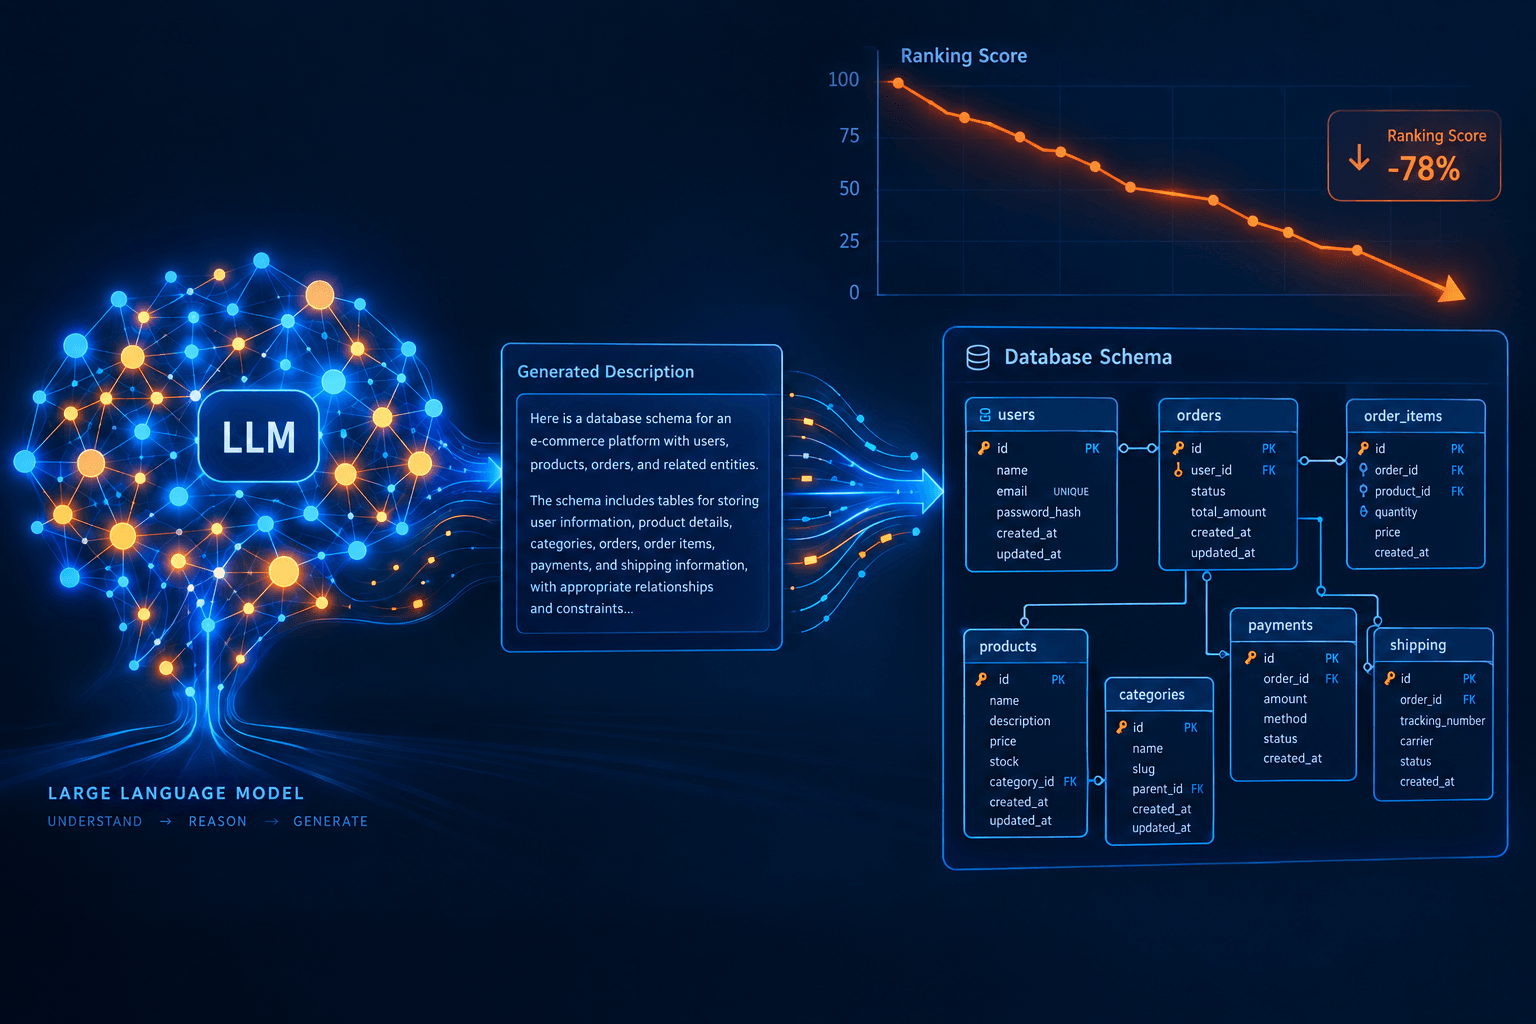
توضیح خودکار ۱۲۴۵ جدول با هوش مصنوعی؛ چرا جستجو بدتر شد؟
افزودن توضیحات تولیدشده توسط مدلهای زبانی به اسناد، بهظاهر راهحلی منطقی برای بهبود بازیابی اطلاعات است. اما آزمایش روی ۱۲۴۵ جدول نشان داد این کار نتیجه را بدتر میکند.
نکات کلیدی
- افزودن توضیحات تولیدشده توسط هوش مصنوعی در کنار متن اصلی در یک فیلد واحد، میتواند با رقیق کردن فراوانی معکوس اسناد (IDF) و تحریف نرمالسازی طول، دقت بازیابی را بهشدت کاهش دهد.
- راهحل پایدار، ایجاد ایندکسهای مجزای BM25 برای زمینههای مختلف (مثلا نامها و توضیحات) و ادغام رتبههای آنهاست، نه ادغام امتیازها.
- این الگو محدود به پایگاهداده نیست و در هر سیستمی که خلاصه، سؤال فرضی یا متن جایگزین تولیدشده را ایندکس میکند (مثلا جستجوی اسناد یا RAG) میتواند رخ دهد.
وقتی کاربر از شما میپرسد «هزینه سرانه ماهانه هر عضو را نشان بده» و سیستم باید آن را به جدول مرموز v_pmpm در پایگاهداده وصل کند، اولین ایدهای که به ذهن میرسد، استفاده از هوش مصنوعی برای توضیح دادن جداول است. اما یک مهندس با آزمایشی دردسرساز روی یک اسکیمای واقعی با ۱۲۴۵ شیء، کشف کرد که این «راهحل آشکار» میتواند دقیقا برعکس عمل کند و دقت بازیابی (Recall) را نه کمی، بلکه بهشکلی چشمگیر کاهش دهد.
آزمایشی که نتیجه معکوس داد
هدف ساده بود: برای هر جدول در یک اسکیمای پیچیده (مثلا یک سیستم CRM)، از یک مدل زبانی بزرگ (LLM) خواسته شد تا یک توضیح انگلیسی ساده و قابلفهم تولید کند. سپس این توضیحات، در کنار نامهای فنی جداول (مثل ecm_template_link)، ایندکس شدند تا شکاف واژگانی بین سؤال کاربر و دنیای پایگاهداده پر شود. انتظار این بود که حالا سیستم زبان انگلیسی را بفهمد.
اما نتیجه شوکهکننده بود. بهعنوان مثال، جدولی به نام contacts که در پاسخ به سؤال «مخاطبین xmagnet را نشان بده» قبل از این فرایند در رتبه ۳ نتایج قرار داشت، بعد از افزودن توضیحات هوش مصنوعی، به زیر رتبه ۴۰ سقوط کرد — جایی خارج از محدودهای که معمولا در یک پرامپت گنجانده میشود. جالب اینجا بود که توضیحات تولیدشده بد یا نادرست نبودند. آنها دقیق و خاص بودند، ولی سیستم را بدتر کردند.
چرایی شکست: وقتی «مخاطب» به کلمهای بیمعنا تبدیل میشود
علت این شکست، به دو پایه الگوریتم رتبهبندی محبوب BM25 برمیگردد: «فراوانی معکوس اسناد» (IDF) و «نرمالسازی طول».
فروپاشی IDF: فرمول IDF به یک کلمه بر اساس کمیاب بودنش در کل مجموعه اسناد امتیاز میدهد. کلمهای که فقط در چند سند ظاهر شود، اطلاعاتی و باارزش است. اما وقتی از یک مدل زبانی بخواهید جدولهای یک CRM را توضیح دهد، درباره چه چیزی مینویسد؟ درباره «مخاطب» (Contact).
مدل نه فقط برای جدول contacts، بلکه برای contact_lists، campaign_recipients، email_events و حتی جدول Audit که تغییرات را ثبت میکند — به یک معنا — درباره «مخاطب» مینویسد. این توضیحات غلط نیستند، بلکه همبستگی بالایی دارند. پس از فرایند توضیحنویسی، کلمه contact از حضور در فقط ۱۷ سند (نام جداول)، به حضور در حدود ۱۰۷۲ سند از ۱۲۴۵ سند رسید. مقدار IDF آن از ۴.۲۷ به ۰.۱۵ سقوط کرد. در این نقطه، از نظر الگوریتم رتبهبندی، کلمهای حیاتی مانند «مخاطب» به اندازه کلمههای عمومی و بیمصرفی مثل «the» یا «and» بیارزش شد.
تحریف نرمالسازی طول: بخش دیگر BM25 اسناد طولانی را جریمه میکند، با این فرض که اگر کلمهای در یک سند کوتاه باشد، آن سند احتمالا مرتبطتر است. در یک اسکیمای پایگاهداده، مرکزیترین و مهمترین جدول (مثلا contacts) معمولا بیشترین تعداد ستونها را دارد. وقتی توضیح تولیدشده را به آن اضافه کنید، طول سندش چندین برابر میانگین مجموعه میشود. در مقابل، جدولی فرعی مثل contact_import_log که ستونهای کمتری دارد، سندی کوتاهتر تولید میکند.
نتیجه؟ دو اثر مخرب همجهت میشوند: IDF دیگر contacts را از چهل جدول دیگر که به آن اشاره میکنند متمایز نمیکند، و سپس نرمالسازی طول، باقیمانده نتایج را برعکس مرکزیت مرتب میکند. یعنی جدولهای فرعی و کماهمیتتر، بالاتر از جدول اصلی قرار میگیرند.
راهحل غلط اول: کمکردن وزن توضیحات
اولین واکنش منطقی ممکن است این باشد: وزن متن تولیدشده را در محاسبه امتیاز کم کنیم. این کار کمی کمک میکند، اما راه درستی نیست. چون این کاهش وزن بعد از محاسبه IDF روی مجموعهای که حالا آلودهشده اعمال میشود. کلمه contact کماکان در امتیازدهی به خود نام جدول، ارزش ناچیز ۰.۱۵ را دارد. بهعبارت دیگر، شما فقط یک کانال خراب را کمصدا کردهاید، نه اینکه کانال سالم را دوباره دقیق کنید.
هزینه این کار واقعی است. با کمکردن وزن توضیحات، پل ارتباطی حیاتی برای سؤالهایی که هیچ راه لغوی به نام جدول ندارند از بین میرود. مثلا سؤال «هزینه سرانه ماهانه هر عضو» تنها از طریق توضیح تولیدشده میتوانست به جدول v_pmpm متصل شود. کمکردن وزن، این دستاوردها را فدا میکند تا بخشی از ضررها جبران شود.
راهحل کارآمد: جستجوی چندمیدانی و ادغام رتبه
راهحل پایدار، ایجاد ایندکسهای جداگانه BM25 برای زمینههای مختلف اطلاعات و سپس ادغام رتبههای آنهاست. در این آزمایش، سه ایندکس مجزا ایجاد شد:
- ایندکس نامها: فقط شامل شناسهها — نام اسکیما، نام جدول و نام جدول با جداکننده underline (مثلا
contact list). - ایندکس متون: شامل تمام توضیحات تولیدشده، راهنماها و کامنتهای ستونها.
- ایندکس بدنه اصلی: شامل همهچیز (ترکیب دو مورد بالا).
سپس بهجای ادغام امتیازها، رتبههای بهدستآمده از هر ایندکس با روشی مانند «ادغام رتبه متقابل» (RRF) ترکیب شدند.
چرا این روش جواب میدهد؟
- IDF دوباره معنا پیدا میکند: در ایندکس نامها، توضیحات تولیدشده هیچ نقشی ندارند. بنابراین کلمه
contactکماکان فقط در ۱۷ سند ظاهر میشود و IDF آن ۴.۲۷ باقی میماند. قدرت تشخیصدهندگیاش ۲۸ برابر برمیگردد. - طول سند تحریف نمیشود: طول سند در ایندکس نامها فقط به طول نام جدول بستگی دارد.
contactsچه ۵۵ ستون داشته باشد چه ۵، در این ایندکس همیشه دو توکن (contactsوcontact) است. بنابراین جریمه ناعادلانه طول از بین میرود. - ادغام رتبه، ریسک را محدود میکند: اگر توضیحات تولیدشده توسط یک مدل ضعیف، کلی و یکسان باشند (مثلا «اطلاعات کاربران و تنظیمات آنها را ذخیره میکند» برای همه ۱۲۴۵ جدول)، آنگاه کانال «متون» به یک کانال یکنواخت و بیفایده تبدیل میشود. در ادغام رتبه، چنین کانالی هیچ تمایزی ایجاد نمیکند و نتیجه نهایی را کانالهای دیگر (نامها و بدنه اصلی) تعیین میکنند. کف نتیجه تبدیل میشود به «بدتر از قبل نباشد» بهجای «بدتر از قبل باشد». این ویژگی استفاده از مدلهای کوچکتر یا آزمایشی را بیخطر میسازد.
این فقط مشکل پایگاهداده نیست
این الگو محدود به متنبهاسکیوال (Text-to-SQL) نیست. هرجا متنی تولیدشده را در کنار متن اصلی، در همان فیلد ایندکس کنید، در معرض این دو اثر مخرب هستید:
- خلاصههای اضافهشده به قطعات متنی: هر خلاصه در یک مجموعه اسناد درباره Kubernetes حتما کلمه «Kubernetes» را تکرار میکند و ارزش تشخیصی آن را از بین میبرد.
- تولید سؤال فرضی (نمایهگذاری به سبک HyDE): شما در حال سنتز عبارتهای خود کاربر، در ابعاد انبوه و برای همه اسناد هستید. این همان رقیقسازی IDF است، اما بهعنوان یک ویژگی محصول!
- توسعه کلیدواژه و مترادفها.
- عنوانها یا متن جایگزین تولیدشده توسط هوش مصنوعی که در فیلد بدنه ادغام میشوند.
هیچکدام از این تکنیکها ایدههای بدی نیستند. حتی نویسنده این آزمایش نیز کماکان از توضیحنویسی جداول استفاده میکند، چون بازیابی برای سؤالهایی با عبارتهای کسبوکار با توضیحات بهتر عمل میکند. ادعا این است: محتوای تولیدشده همیشه باید در فیلد مجزای خود ایندکس شود. هزینه جداکردن فیلدها، ساخت یک ایندکس اضافه و یک مرحله ادغام است. هزینه نادیده گرفتن این جداسازی، یک پسرفت (Regression) است که فقط روی مهمترین پرسوجوهای شما ظاهر میشود و ممکن است به اشتباه بهعنوان «ذاتا سخت بودن بازیابی» تفسیر شود.
چگونه بفهمید مشکل دارید؟
بررسی این موضوع ساده است. ده اسم پرکاربردی که کاربران شما تایپ میکنند (مثلا «مشتری»، «صورتحساب»، «تراکنش») را در نظر بگیرید. فراوانی سند (Document Frequency) آن کلمات را قبل و بعد از مرحله غنیسازی (Enrichment) محاسبه و مقایسه کنید. اگر بعد از غنیسازی، هر یک از آن کلمات در بیش از نیمی از اسناد شما ظاهر شدند، آن کلمه دیگر هیچ کمکی به تشخیص نمیکند — و احتمالا قبل از این کار مفید بود.
ابزارهای مرتبط والور
سوالات متداول
آیا توضیحات تولیدشده توسط هوش مصنوعی همیشه مضر هستند؟
خیر، توضیحات تولیدشده میتوانند برای سؤالهایی که هیچ راه لغوی به اسناد اصلی ندارند (مثلا «هزینه سرانه ماهانه» به جدول v_pmpm) حیاتی باشند. مشکل زمانی رخ میدهد که این توضیحات در همان فیلد متن اصلی ایندکس شوند و مکانیسمهای رتبهبندی را تحریف کنند.
راهحل «جستجوی چندمیدانی» دقیقا چه میکند؟
این راهحل با ایجاد ایندکسهای مجزا برای انواع مختلف محتوا (مثلا یک ایندکس فقط برای نامها و یک ایندکس فقط برای توضیحات) و سپس ادغام رتبههای بهدستآمده از هر ایندکس، از آلوده شدن معیارهای کلیدی مانند IDF و نرمالسازی طول هر بخش توسط بخش دیگر جلوگیری میکند.
این مشکل فقط در سیستمهای متنبهاسکیوال (Text-to-SQL) رخ میدهد؟
خیر. این یک الگوی عمومی است. هر سیستم بازیابی اطلاعات (RAG) که خلاصه، سؤال فرضی، عنوان جایگزین یا مترادفهای تولیدشده توسط هوش مصنوعی را در فیلد اصلی سند ادغام کند، در معرض همین اثرات رقیقسازی IDF و تحریف طول سند قرار دارد.
منابع
- I described 1,245 tables with an LLM and retrieval got worse — DEV Community
این مقاله با کمک هوش مصنوعی از منابع بالا تدوین و توسط امیرعلی کریمی بازبینی شده است. قوانین محتوایی والور
بنیانگذار و سردبیر والور
امیرعلی کریمی بنیانگذار و سردبیر والور است. مقالههای والور با کمک هوش مصنوعی و بر پایهی چند منبع معتبر بینالمللی تدوین میشوند و من پیش از انتشار، هر مطلب را از نظر درستی اطلاعات، روانی متن و منابع بازبینی و تایید میکنم. منابع هر مقاله در انتهای همان صفحه فهرست شدهاند.
مطالب مرتبط
Livenerf؛ پروژهای برای ردیابی افت کیفیت پنهان مدلهای هوش مصنوعی پس از عرضه
Livenerf یک پروژهی متنباز است که با روشی علمی و از پیش ثبتشده، به دنبال پاسخ به این پرسش رایج است: «آیا مدلهای هوش مصنوعی مانند Claude Opus پس از عرضه، بهطور پنهانی ضعیفتر میشوند؟»
معماری توسعه نرمافزار در عصر هوش مصنوعی: از کدنویس تا مهندس زمینه
آیندهی برنامهنویسی دیگر دربارهی تعداد خطوط کد نیست. با ظهور مدلهای «سیستم ۱» و پروتکل MCP، نقش توسعهدهنده از کدنویس به معمار سیستمهای خودگردان هوش مصنوعی در حال تغییر است.
جدال سرعت در هوش مصنوعی؛ از درخواست ترمز تا اختلاف نظرهای ایمنی
مدیران شرکتهای پیشروی هوش مصنوعی میگویند سرعت توسعه باید کنترلشده باشد؛ در مقابل، برخی رهبران صنعت راهحل را در مهندسی ایمنی و خودنظارتی میبینند. این شکاف اخیرا پررنگتر شده است.