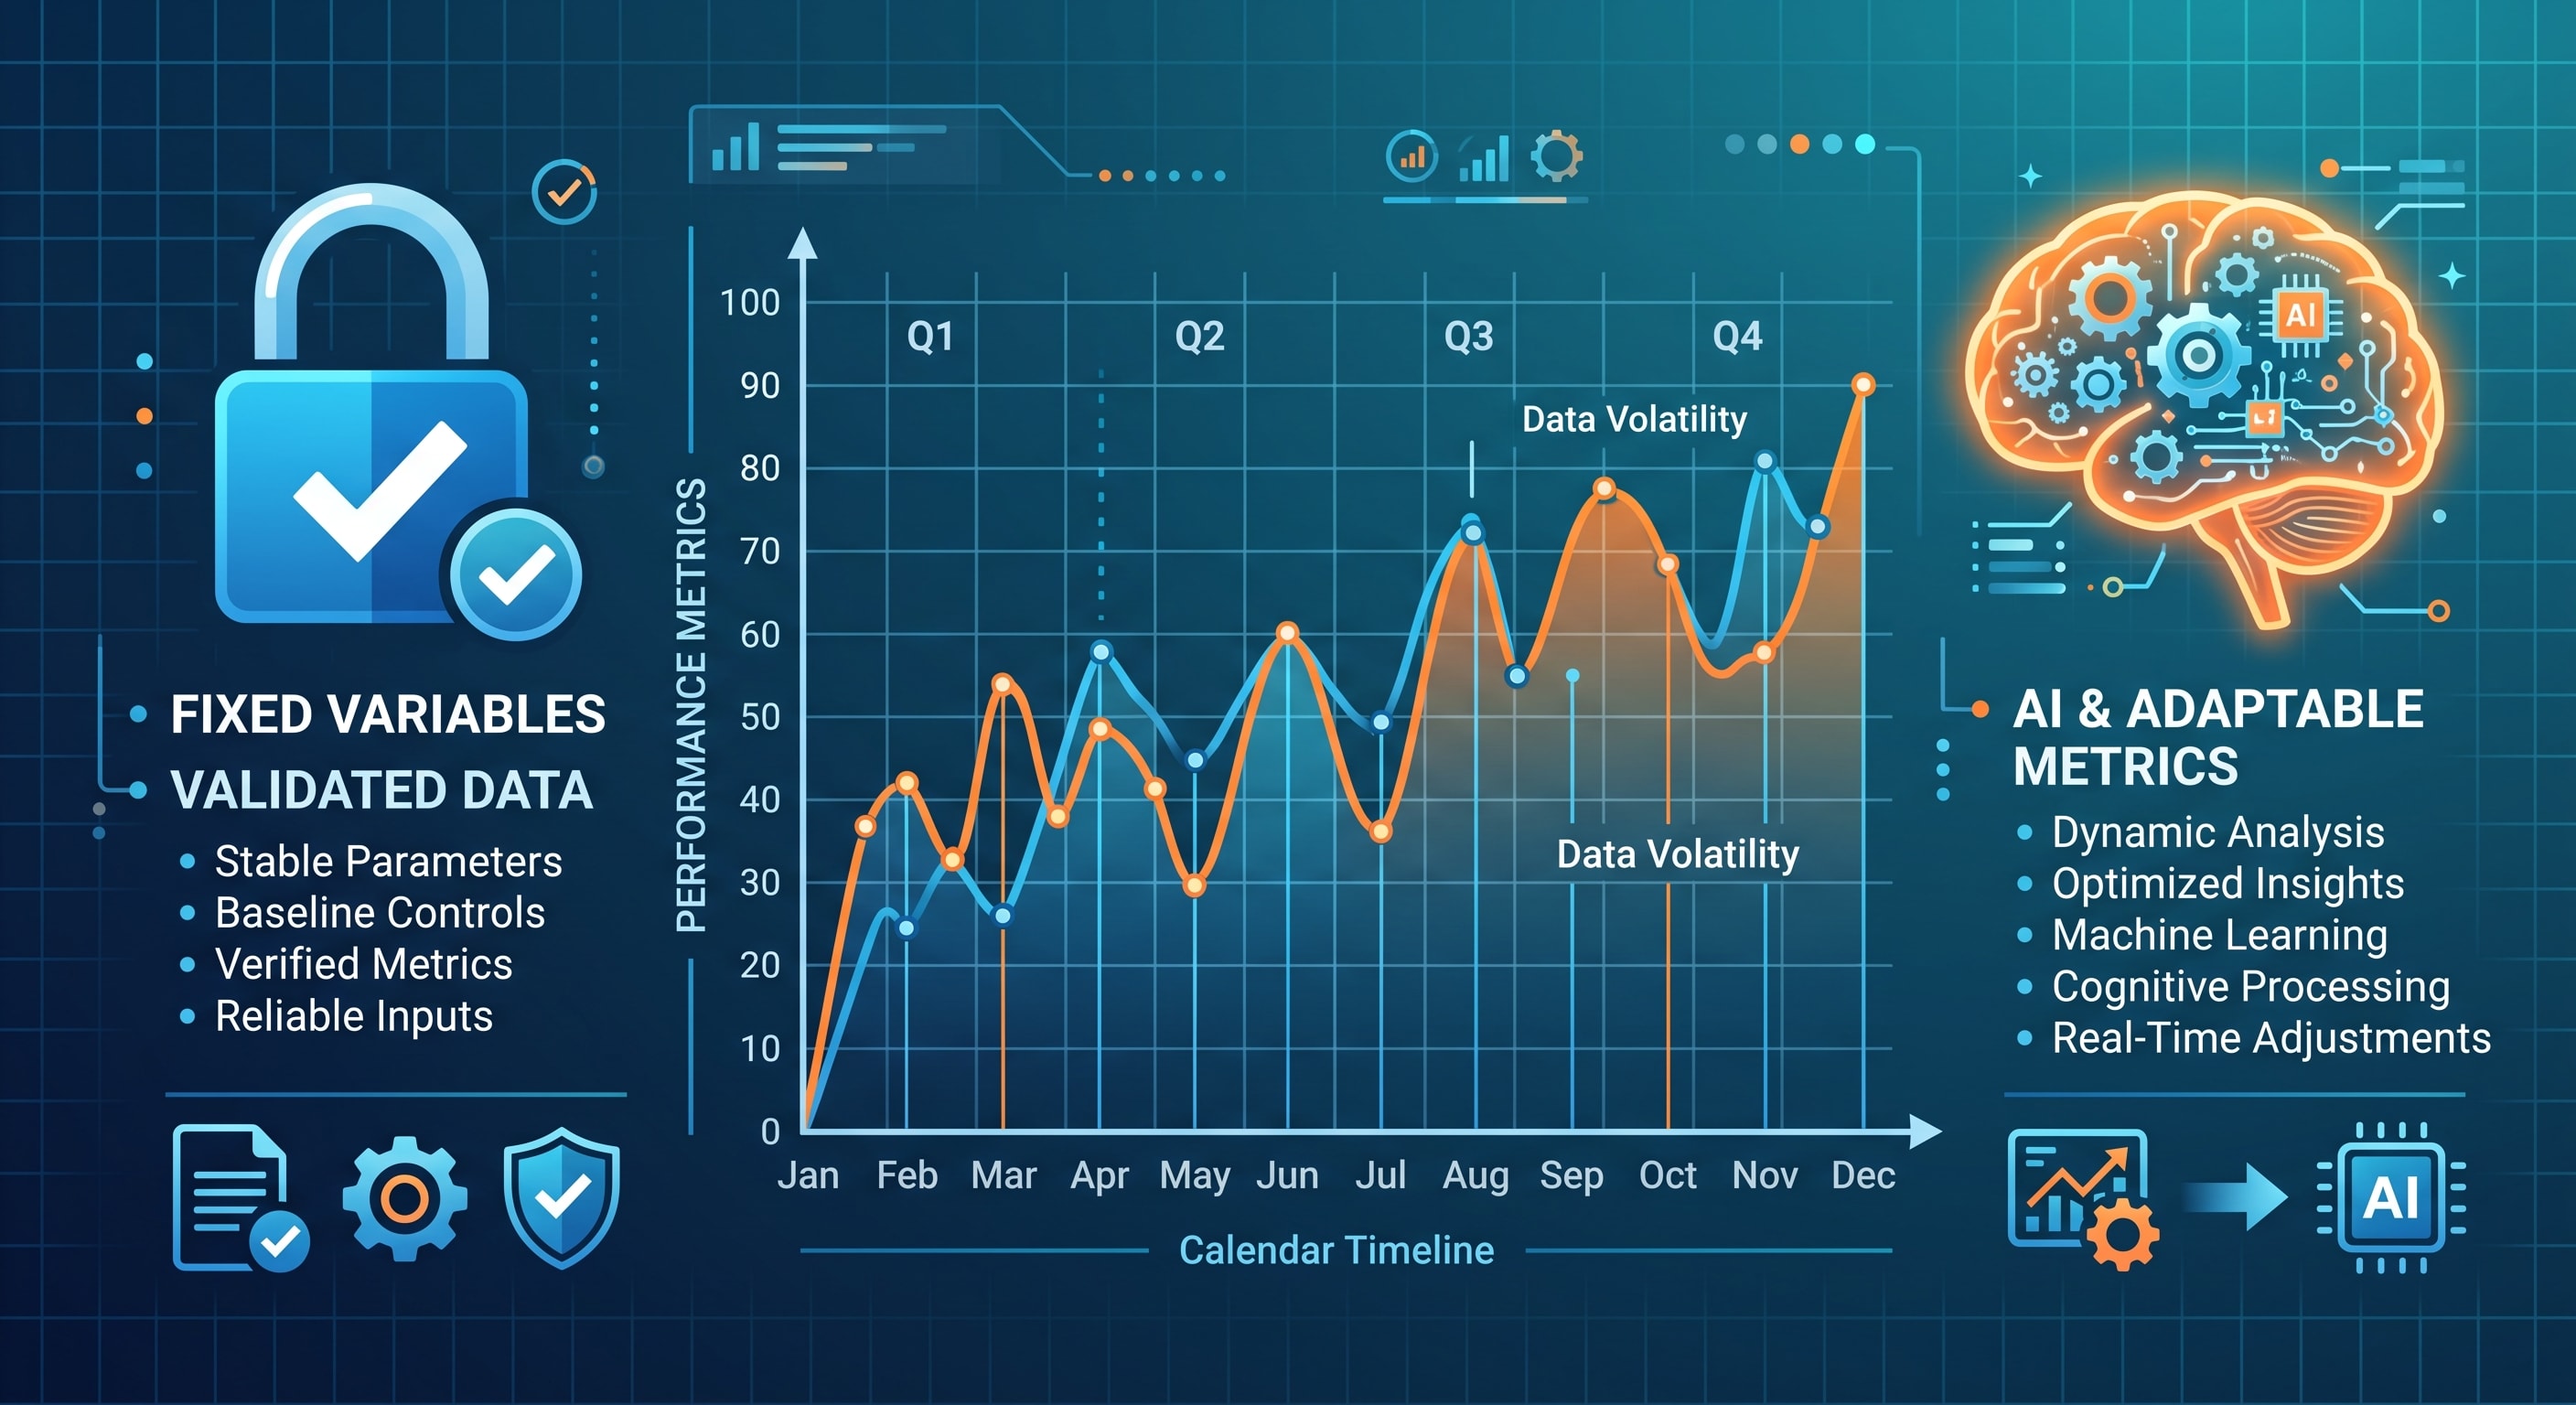
Livenerf؛ پروژهای برای ردیابی افت کیفیت پنهان مدلهای هوش مصنوعی پس از عرضه
Livenerf یک پروژهی متنباز است که با روشی علمی و از پیش ثبتشده، به دنبال پاسخ به این پرسش رایج است: «آیا مدلهای هوش مصنوعی مانند Claude Opus پس از عرضه، بهطور پنهانی ضعیفتر میشوند؟»
نکات کلیدی
- Livenerf یک بنچمارک متنباز است که با دادههای از پیش ثبتشده به پرسش «ضعیفتر شدن پنهانی» مدلهایی مثل Claude Opus پس از عرضه پاسخ میدهد.
- با ثابت نگهداشتن همهی عوامل غیر از خود مدل و استفاده از پنل ۷۸ سؤال «گاهی درست»، تغییرات آماری معنادار در بازههای ۱۰ روزه رصد میشود.
- افت کیفیت معمولا اول با کاهش تعداد توکنهای خروجی (کمتر فکر کردن مدل) دیده میشود و Livenerf این سیگنال را هم دنبال میکند.
ماههاست در انجمنهای هوش مصنوعی بحث میشود که آیا شرکتهایی مثل Anthropic بعد از عرضهی اولیه، مدلهای خود را «ضعیفتر» (Nerf) میکنند یا نه. این ادعاها معمولا به تغییرات پنهانی اشاره دارند؛ مثلا فشردهسازی (Quantization)، جایگزینی یک مدل کوچکتر با همان نام، کمکردن تلاش محاسباتی یا دستکاری در مسیریابی درخواستها. تا امروز بیشتر این بحثها بر پایهی حس و تجربههای پراکنده بوده و خطمبنای دقیق و دادهی قابل اتکایی از روز اول عرضه وجود نداشته است.
اکنون پروژهای به نام Livenerf برای پایان دادن به این حدسوگمانها و جایگزینکردن «حس در برابر حس» با «داده در برابر داده» راه افتاده است. این پروژه که یک توسعهدهندهی مستقل با نام کاربری ninjahawk آن را روی GitHub منتشر کرده، یک بنچمارک کوچک، یکنواخت و فقط افزایشی (append-only) است که یک پرسش ساده را دنبال میکند: «آیا یک مدل بعد از عرضه بدتر میشود؟»
هدف Livenerf چیست؟
هدف Livenerf مشخص و محدود است: ردیابی تواناییهای مدل Claude Opus 5.5 از Anthropic از طریق سرویس Claude Code، طی ۳۰ روز بعد از عرضه. این مدل در ۲۲ سپتامبر ۲۰۲۶ (۱ مهر ۱۴۰۵) منتشر شد و Livenerf از همان روز کار را شروع کرده است. نکتهی مهم این است که سنجش از طریق رابط کاربری اشتراکی Claude Code انجام میشود، نه API خام؛ دقیقا همان جایی که بیشتر گزارشهای افت کیفیت به آن اشاره دارند و تجربهی کاربر نهایی را نشان میدهد.
چگونه کار میکند؟
چون امکان قطعیکردن کامل مدلهایی مثل Opus 5.5 وجود ندارد—حتی با حذف پارامترهای نمونهبرداری و اینکه قابلیت «تفکر» خاموششدنی نیست—Livenerf تلاش میکند همهچیز دیگر را تا حد امکان ثابت نگه دارد.
ثابتسازی همهچیز:
- پرامپتهای منجمد: یک دستور سیستم کوتاه و ثابت برای همهی درخواستها.
- CLI پینشده: نسخهی دقیق رابط خط فرمان Claude Code قفل میشود و بهروزرسانی خودکار غیرفعال است؛ چون تغییر در ابزار میتواند شبیه تغییر در خود مدل دیده شود.
- تصحیحگرهای دقیق: نمرهدهی پاسخها با توابع خالص (Pure Function) و بدون استفاده از مدلهای دیگر انجام میشود تا از رانش (Drift) در ارزیابی جلوگیری شود.
- لاگهای خام دائمی: همهی دادههای خام—پرامپت، پاسخ، تاخیر، نسخهی CLI—به شکل فقط افزایشی ذخیره میشوند و ویرایش یا حذف نمیگردند.
انتخاب هوشمندانهی سؤالها: اجرای سؤالهایی که مدل همیشه درست جواب میدهد، فقط منابع را هدر میدهد و چیزی دربارهی افت نشان نمیدهد. Livenerf ابتدا از هزاران سؤال در مجموعههای استانداردی مثل GPQA Diamond، MMLU-Pro و مسابقات ریاضی نمونهبرداری میکند تا سؤالهایی را پیدا کند که مدل «گاهی» درست پاسخ میدهد (با نرخ موفقیت حدود ۳۰ تا ۷۰ درصد). این سؤالها بیشترین اطلاعات را برای تشخیص تغییر حمل میکنند. از میان بیش از ۲۳۰۰ سؤال اولیه، ۷۸ سؤال بهعنوان پنل اصلی انتخاب و قفل شدند.
روش آماری و از پیش ثبتشده:
- مقایسهی جفتی: هر سؤال در پنل طی هفتهها تکرار میشود و عملکرد آن نسبت به خطمبنای خودش در ۱۰ روز اول سنجیده میشود تا اثر دشواری ذاتی سؤال حذف شود.
- خطاهای استاندارد خوشهای: از روشهای آماری استاندارد (طبق راهنمای Anthropic با عنوان «Adding Error Bars to Evals») برای محاسبهی عدمقطعیت استفاده میشود.
- قانون تصمیمگیری روشن: یک تغییر فقط وقتی «واقعی» محسوب میشود که فاصلهی اطمینان ۹۹٪ در دو بازهی ۱۰ روزهی پیدرپی صفر را پوشش ندهد، اندازهی اثر حداقل ۳ امتیاز باشد و در بازوی کنترل دیده نشود.
- پیشثبت (Pre-registration): همهی مراحل—روش انتخاب سؤال، معیارهای اعتبارسنجی و قانون تصمیمگیری—پیش از شروع جمعآوری دادهها در سند عمومی
PREREGISTRATION.mdثبت و با زمانمهر GitHub ذخیره میشود تا از سوگیریهای پس از داده جلوگیری شود.
کنترل و اعتبارسنجی: چطور به نتایج اعتماد کنیم؟
Livenerf چند لایهی کنترل و اعتبارسنجی دارد تا مطمئن شود هر تغییری از خود مدل میآید نه از عوامل بیرونی.
- بازوی کنترل: همزمان با تست Opus 5.5، مدل قدیمیتر Claude Opus 5 هر روز همان مجموعهی سؤالهای GPQA را اجرا میکند. اگر هر دو مدل با هم تغییر کنند، احتمالا مشکل از ابزار سنجش (Harness) یا پلتفرم است، نه از خود Opus 5.5.
- اعتبارسنجی مثبت: قبل از شروع خطمبنا، سیستم عمدا در معرض یک «افت شناختهشده» قرار میگیرد تا نشان دهد توان تشخیص دارد. برای نمونه، مشخص شد وقتی سطح «تلاش» (Effort) مدل از «بالا» به «متوسط» تغییر میکند، میانگین توکنهای خروجی ۲۶٪ کم و دقت حدود ۴.۲ امتیاز افت میکند؛ Livenerf این تغییر را بهروشنی ثبت کرد.
- اندازهگیری تلاش: جالب اینکه افت کیفیت معمولا اول در حجم خروجی دیده میشود، نه دقت. اگر مدل کمتر «فکر» کند، تعداد توکنهای تولیدی پایین میآید و ممکن است این نشانه قبل از افت محسوس در دقت رخ دهد. Livenerf تعداد توکنهای خروجی را بهعنوان یک سیگنال ثانویهی مهم دنبال میکند.
محدودیتها و نکتههای مهم
- حساسیت محدود: آزمایشها نشان دادهاند این سیستم نمیتواند جایگزینی Opus 5.5 با Opus 5 را با اطمینان ۹۹٪ تشخیص دهد (افت حدود ۳.۸ امتیاز با خطای ۶.۳). پس Livenerf برای تشخیص تغییرات خیلی کوچک داخل یک خانوادهی مدلی ساخته نشده است.
- خطمبنا الزاما بهترین حالت نیست: هفتهی اول عرضه ممکن است بهخاطر باگهای زیرساخت، فشار سرورها یا مشکلات راهاندازی بدترین عملکرد را داشته باشد. Livenerf فقط تغییر نسبت به همان هفته را اندازه میگیرد، نه فاصله از یک نقطهی ایدهآل.
- گزارش بهبود: هدف Livenerf فقط پیدا کردن افت نیست؛ اگر مدل در گذر زمان بهتر شود، این بهبود هم به همان وضوح گزارش میشود.
پیشزمینهی فنی و روش استفاده
این پروژه بر پایهی چارچوب ارزیابی متنباز Inspect از مؤسسهی امنیت هوش مصنوعی بریتانیا ساخته شده است. برای اجرا به Python 3.11، نصبکنندهی uv و یک حساب فعال در Claude Code با اشتراک Max نیاز دارید.
دادههای این سری زمانی از ۲۴ سپتامبر ۲۰۲۶ (۳ مهر ۱۴۰۵) شروع شده و روزی یکبار به مدت ۳۰ روز اجرا میشود. نخستین بازهی ۱۰ روزه خطمبنا را میسازد و اولین نتیجهی قابل استناد حدود ۲۴ اکتبر ۲۰۲۶ (۲ آبان ۱۴۰۵) منتشر خواهد شد. در زمان نگارش این مقاله (۲۹ سپتامبر)، دادههای ۶ روز از ۳۰ روز جمعآوری شده است.
چرا Livenerf مهم است؟
Livenerf فقط یک پروژهی فنی نیست؛ تلاشی برای شفافیت بیشتر در دنیای مدلهای هوش مصنوعی است. با ارائهی روشی استاندارد، قابلتکرار و از پیش ثبتشده، امکان میدهد سازندگان نسبت به عملکرد مدلهایشان پس از عرضه پاسخگو باشند و کاربران بر پایهی داده تصمیم بگیرند، نه برداشت شخصی. اگر این رویکرد موفق باشد، میتواند الگوی پایش مستقل دیگر مدلهای مرزی (Frontier Models) در آینده شود.
ابزارهای مرتبط والور
سوالات متداول
هدف اصلی پروژه Livenerf چیست؟
ارائهی پاسخ مبتنی بر داده به این پرسش که آیا مدلهای پیشرفتهی هوش مصنوعی مانند Claude Opus 5.5 پس از عرضهی عمومی، بهطور پنهانی و بدون اطلاع کاربران ضعیفتر میشوند یا نه. این کار با ردیابی دقیق عملکرد مدل در یک بازهی ۳۰ روزه انجام میشود.
Livenerf چگونه از قضاوت بر اساس احساسات جلوگیری میکند؟
با ثابت نگهداشتن همهی عوامل غیر از خود مدل (مثل پرامپت، نسخهی نرمافزار و روش نمرهدهی)، استفاده از روشهای آماری استاندارد و مهمتر از همه، پیشثبت (Pre-registration) همهی مراحل و معیارهای تحلیل پیش از شروع جمعآوری دادهها؛ این کار شفافیت میآورد و از سوگیریهای پس از داده جلوگیری میکند.
اولین نتایج قطعی Livenerf چه زمانی منتشر میشود؟
به گزارش مخزن پروژه، جمعآوری دادهها از ۲۴ سپتامبر ۲۰۲۶ شروع شده و روزی یکبار به مدت ۳۰ روز ادامه دارد. اولین تحلیل معنادار که دو بازهی ۱۰ روزه را پس از خطمبنا مقایسه میکند، حدود ۲۴ اکتبر ۲۰۲۶ (۲ آبان ۱۴۰۵) منتشر خواهد شد.
منابع
- Livenerf: Has Opus 5.5 been nerfed yet? — Hacker News
این مقاله با کمک هوش مصنوعی از منابع بالا تدوین و توسط امیرعلی کریمی بازبینی شده است. قوانین محتوایی والور
بنیانگذار و سردبیر والور
امیرعلی کریمی بنیانگذار و سردبیر والور است. مقالههای والور با کمک هوش مصنوعی و بر پایهی چند منبع معتبر بینالمللی تدوین میشوند و من پیش از انتشار، هر مطلب را از نظر درستی اطلاعات، روانی متن و منابع بازبینی و تایید میکنم. منابع هر مقاله در انتهای همان صفحه فهرست شدهاند.
مطالب مرتبط

معرفی Beam: مدل ۵۰۱ میلیارد پارامتری Reflection؛ رقیب کارآمد برای مدلهای مطرح
استارتاپ Reflection مدل متنباز Beam را معرفی کرد؛ یک مدل ۵۰۱ میلیارد پارامتری با تمرکز بر کدنویسی و استدلال که ادعا میکند با مصرف محاسباتی بسیار کمتر، به عملکردی همرده با مدلهای پیشرو دست مییابد.
آیفون ۱۸ پرو معرفی شد؛ دوربین متغیر و باتری رکوردشکن بههمراه نگرانی تعمیرپذیری
اپل آیفونهای ۱۸ پرو و پرو مکس را با دوربین اصلی دارای دیافراگم متغیر، تراشهی A20 Pro و افزایش عمر باتری معرفی کرد. اما گزارشهای اولیه از یک مشکل احتمالی در قاب پلاستیکی نمایشگر و چالشهای تعمیر
توافق رهبرانهوش مصنوعی برای کاهش سرعت؛ پیمان امنیتی یا کارتل انحصاری؟
رهبران شرکتهای بزرگ هوش مصنوعی از جمله مدیرعاملان OpenAI و Anthropic بهطور غیررسمی موافقت کردهاند که توسعه این فناوری را کند کنند. اما انگیزه اصلی آنها چیست؟ امنیت یا حفظ برتری؟